# 超越相似度:中国古代史书互文的智能体抽取与专家评测
这是 的 Markdown 版本。
[王兆基](https://www.zhaoji.ac.cn/)1,2、[司宛玉](https://pkudh.org/member/wanyu.html)1,2、[王军](https://pkudh.org/member/wangjun2025.html)1,2\*
- 1 北京大学信息管理系
- 2 北京大学数字人文研究中心
\* 通讯作者
- [arXiv:2607.27595](https://arxiv.org/abs/2607.27595)
- [PDF](https://arxiv.org/pdf/2607.27595v1)
- [互文图谱](https://analects-24histories-intertext.pkudh.net/)
我们让大语言模型智能体抽取互文:它提出的每一处复用,都要定位到两侧原文的字符区间,并标注复用方式。方法在《论语》与《汉书》之间 2,533 条经专家裁定的互文对上验证。在成书于公元前 91 年至 1739 年的正史中,直接引用和无标记复用的占比都未检出系统性变化;但较晚成书的史书引用同一段原文时,往往不如较早的史书贴近字面。
## 一览
- **2,533**:《论语》与《汉书》之间经专家裁定的互文对
- **55.9%~92.9%**:12 个大语言模型在这一基准上的精确率
- **51 倍**:精确率最高的 `doubao-2.1-turbo` 与 `deepseek-v4-flash` 每条有效互文对的成本之比,后者精确率低 4.9 个百分点
- **5,766**:`deepseek-v4-flash` 在二十四史上做 65,380 次比对抽取出的互文对。若它在《汉书》上 88.0% 的精确率在此同样成立,其中约每 8 条有 1 条是误报。
## 摘要
互文性的计算方法已从字符串匹配发展到神经检索,但它们输出的相似度分数和平行段落列表,只能指出文本在哪里相互复用,说明不了怎样复用、为何复用。我们把细粒度的互文抽取改写为一项智能体任务:大语言模型(LLM, Large Language Model)完整读入两个文本单元,只能通过受约束的工具接口提交结果;它提出的每一处复用,都必须定位到两侧的精确字符区间,并按五维复用类型学(复用形式、复用层面、来源标记、互文功能、立场)标注。我们在《论语》与《汉书》的穷尽比对上验证这一方法:多个模型提出的候选汇集起来,由三位领域专家裁定,构成包含 2,533 条互文对的基准。以此为标准,我们考察了十二个大语言模型,报告它们的精确率(56%~93%)、质量相近时多达 51 倍的成本差距,以及置信度的校准程度。专家之间的一致性呈现出一条「信度梯度」:证据在文本表面的维度,标注一致;需要推断意图的维度,存在争议。据此可以划定这类标注能够支撑哪些结论。将验证过的抽取器用于全部二十四史(65,380 次比对,5,766 条互文对)后,我们得到了相似度分数无法表达的语料层面的结构。十八个世纪里,引用的类型构成未见系统性变化,同一段经文却引得越来越不贴近字面。整体稳定、个案渐变,正是文化吸引理论所预期的。我们公开了抽取协议和专家裁定的基准。
## 1. 相似度分数漏掉了什么?
漏掉了复用的类型。分数只记下两段文字重合多少,史家要问的却是:这段话是忠实的称引,是借重经典的权威,还是已经沦为套语。
《汉书》成书于公元 1 世纪,书中几乎逐字转录了《论语》的禅让册命「咨爾舜,天之歷數在爾躬」。同书《王莽传》中,这句话又作「歷數在于予躬」,第二人称悄悄换成了第一人称。到 3 世纪 60 年代,《三国志》所载的禅让文书只剩下一个公式化的骨架「天祿永終,歷數在晉」,它已脱离《论语》,融入了王朝更替的标准文书。文本复用检测器能发现这三处都与《论语》相似,却分辨不出第一处是忠实的称引,第二处是对权威的挪用,第三处是僵死的套语。出处:[引言 · PDF 第 1 页](https://arxiv.org/pdf/2607.27595v1#page=1)
靠人工追踪这类复用,是索引之学的工作。顾颉刚通过文本对勘为传说中的古史分层断代,他提出的「层累地造成的中国古史」说开启了疑古运动。这类对勘受制于专家的精力,顾颉刚自己也只打算一部书一部书地考辨下去。通行的计算方法并没有突破这个限制:它们把每一次比较都归结为一个相似度值,保留了复用的程度,丢掉了复用的类型。因此,我们把互文分析表述为一项关系抽取任务(span-grounded relation extraction):模型要在两侧定位每个被复用的片段,给出精确的字符区间,再按复用类型标注由此构成的互文对。出处:[引言 · PDF 第 1 页](https://arxiv.org/pdf/2607.27595v1#page=1)
## 2. 智能体如何抽取互文并保证结果可核对?
大语言模型智能体把《论语》的一整篇与史书的一整卷对读。它只能通过工具记录复用,而工具会逐字对照原文检查,所以每条提交的互文对都对应两侧原文的精确字符区间,并带有五个维度的标签。
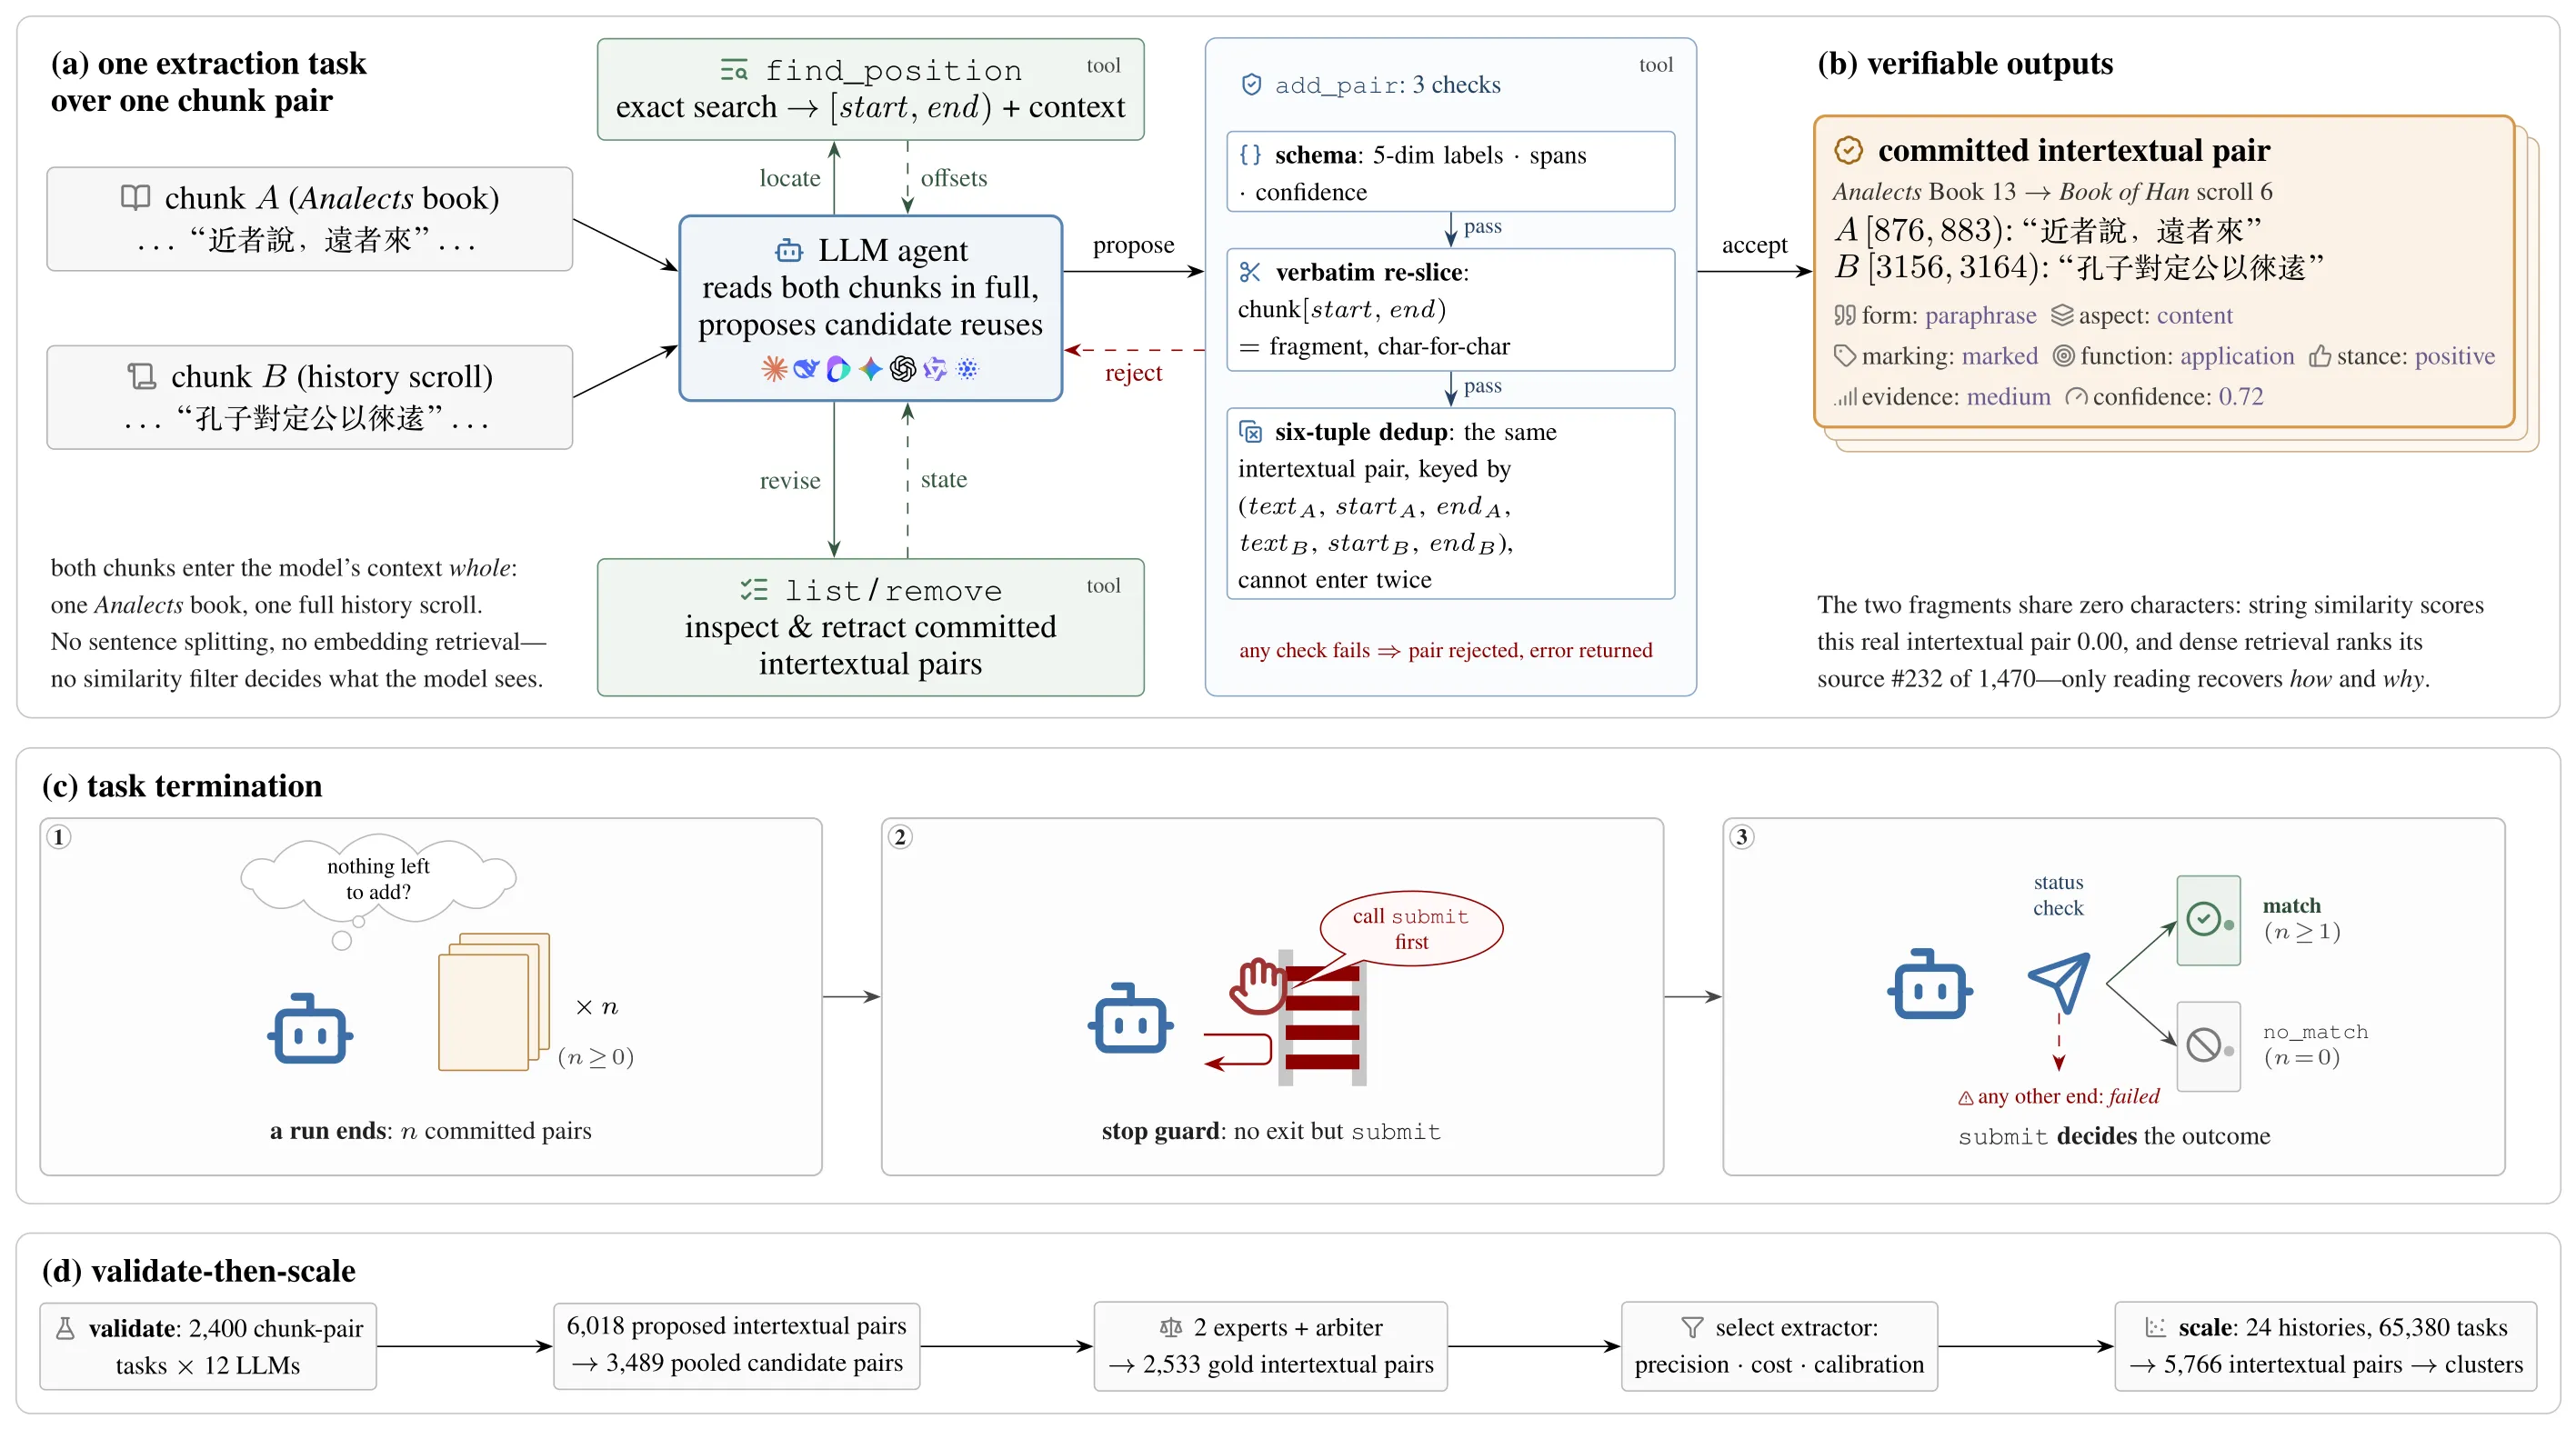
**图 1** 框架总览。(a) 处理单个文本块对的抽取智能体及其工具:`find_position` 把候选措辞定位到精确偏移,`list` 和 `remove` 用于修改,`add_pair` 只在通过图中三项检查后才提交互文对。(b) 图中这条互文对是真实个案,两侧片段没有一个字相同:汉武帝的一道诏书只提孔子之名,援引《论语》第 13 篇。(c) 任务只能通过 `submit` 结束,`submit` 会对照已提交的互文对核对所声明的状态;以其他方式结束的任务记为失败。(d) 先验证、后扩展的流程。[PDF 第 2 页](https://arxiv.org/pdf/2607.27595v1#page=2)
每个任务处理一个文本块对,即《论语》的一篇和史书的一卷,要求找出其中全部互文对。每条互文对由两侧的对应片段构成,片段用字符区间 [start, end) 表示。每条互文对都要在五个维度上标注。复用形式分直接引用和转述。复用层面分内容和结构。来源标记分显性(点明出处)、有标记(有所提示但不点名)和无标记。互文功能指复用在新语境中的作用,分背景、支持、应用和批判。立场指引用者的态度,分肯定、中立、否定和复杂。这里的复用指可以追溯的文本依赖,话题相同、观点一致、常用词重合和泛泛的影响都不算。只有两侧片段都在所给偏移处逐字出现,预测才算正确。出处:[任务与智能体抽取协议 · PDF 第 3 页](https://arxiv.org/pdf/2607.27595v1#page=3)
两个文本块都完整放入模型的上下文。我们不先把它们切成句子、再按 n-gram 或嵌入相似度配对,因为索引只会呈现它已判为相近的内容;而一处引用如何标示来源、起什么修辞作用,只有放回上下文才看得出来。出处:[任务与智能体抽取协议 · PDF 第 3 页](https://arxiv.org/pdf/2607.27595v1#page=3)
如果直接让大语言模型写出被复用的片段,它给出的互文对读来通顺,却可能在原文中找不到,甚至是编造的。所以智能体必须先用定位工具找到每个片段。定位工具在文本块中做精确的子串检索,返回片段的偏移和前后各 30 个字符的上下文。智能体提交互文对时,协议按给出的偏移从两个文本块中重新截取片段;只要有一侧与提交的文字不能逐字吻合,就拒收这条互文对。在十二个模型的运行中,智能体共调用定位工具 319,465 次,平均每次任务尝试约 11 次。在全部提交尝试中,39% 被拒:约四分之一未通过逐字比对,另有 15% 未通过标签与区间的格式检查。拒收反映的是定位能力,不等同于互文判断的质量:精确率最低的模型独占了逐字比对拒收的三分之二,而遇到过拒收的任务尝试中,81% 最终仍提交了通过校验的互文对。去掉定位工具后,拒收率升至原来的九倍,输出 token 数升至五倍。出处:[任务与智能体抽取协议 · PDF 第 3 页](https://arxiv.org/pdf/2607.27595v1#page=3)
从模型自由文本中读出的结论,无法在语料规模上逐条核查。因此协议从不解析任务结束时模型写下的文字,任务的输出就是通过工具提交的互文对集合。工具检查每条互文对的标签与区间,并拒收重复提交;判断是否重复,看两侧片段的文字及各自的偏移。每个任务都隔离运行,使用全新的临时主目录,不继承任何配置。每个任务以一个哈希值为键,哈希覆盖决定结果的全部输入,包括提供模型服务的供应商和接口地址。这样,同名模型由两家供应商提供时,不会悄悄共用缓存结果。出处:[任务与智能体抽取协议 · PDF 第 3 页](https://arxiv.org/pdf/2607.27595v1#page=3)
只有每个任务都以明确的结果结束,汇总计数才可信。智能体调用 `submit` 之前不能结束任务;`submit` 会对照已提交的互文对,双向核对所声明的状态:声明「匹配」,至少要有一条已提交的互文对;声明「无匹配」,则一条也不能有。以其他方式结束的任务,包括接口报错、重试次数用尽、超时,或没有提交就停止的运行,都记为失败,不算作空结果。多数文本块对之间本来没有复用,所以明确声明「无匹配」与找到匹配一样,都是正式的结果。出处:[任务与智能体抽取协议 · PDF 第 3~4 页](https://arxiv.org/pdf/2607.27595v1#page=3)
## 3. 专家裁定的基准有多可靠?
用来比较模型足够可靠,也足以支撑关于复用形式和来源标记的结论。只按两位专家中较严的一位重新计分,模型排名几乎不变;两位专家在这两个标签上的判断也基本一致。互文功能和立场需要推断意图,专家之间存在分歧,相关发现只能算探索性的。
基准以公开的标点整理本(识典古籍)为底本,把《论语》(20 篇,22,919 字符)与《汉书》(120 卷,942,693 字符)穷尽配对,共 2,400 个文本块对任务。十二个大语言模型各自完成全部 2,400 个任务,共提出 6,018 条互文对;把偏移相同的相同片段合并后,得到 3,489 条不同的候选。汇集全部十二个模型的结果,是为了不让基准偏向某一个模型提出的候选;而各模型提出的候选确实大多不同,68% 只由一个模型提出。两位专家独立判断每条候选,先判断是否有效,再为有效的互文对标注五个标签;两人意见不一致时,由第三位专家裁定。最终得到 2,533 条互文对,占候选池的 72.6%。出处:[专家评测 · PDF 第 4 页](https://arxiv.org/pdf/2607.27595v1#page=4)
人工统计也给不出可以替代的参照。两项文献学调查统计《汉书》引用《论语》的次数,分别得到 237 处和 447 处,相差近一倍,两位作者也都估计自己有遗漏。仅在这两部书之间,专家就确认了 954 条带来源标记的互文对;十二个模型各自单独运行时,提交的互文对中经裁定有效的也都在 323~572 条之间。出处:[专家评测 · PDF 第 4~5 页](https://arxiv.org/pdf/2607.27595v1#page=4)
在有效性判断上,两位专家只是宽严不同,标准并无分歧。一位接受了 55.3% 的候选,另一位接受了 99.4%,而且两人的判断是嵌套的:较严的专家接受的候选,较宽的专家一条也没有拒绝。两人都接受的候选有 1,930 条。落在两人阈值之间的 1,539 条,由第三位专家逐条裁定,其中 59.9% 与较严的专家一致,共接受 617 条。另有 1,214 条候选两人都接受、但标签有冲突,也送交裁定,第三位专家把其中 14 条改判为无效。合计 1,930 − 14 + 617 = 2,533 条。若只以较严的专家为准重新计分,每个模型的精确率都下降 9~23 个百分点,排名却几乎不变(Spearman 相关系数 ρ = 0.94,没有模型的名次变动超过两位),部署模型的选择也不变。本页的精确率都以裁定结果为准。出处:[专家评测 · PDF 第 4 页](https://arxiv.org/pdf/2607.27595v1#page=4)
五个标签的一致性按两位专家都接受的 1,930 条候选计算,用的是裁定前的标注,结果呈现一条信度梯度(表 1)。复用形式和来源标记的证据就在文本表面(措辞是否相同,来源是否点名),查看文本即可判定;互文功能和立场需要重建引用者的意图和态度,即便都是行家,也可能各有依据、判断不一。复用层面的一致率为 98.9%,但 97% 的互文对复用的都是内容,仅凭机会就能达到 96.1% 的一致率:这个标签可靠,却几乎是个常量。出处:[专家评测 · PDF 第 4 页](https://arxiv.org/pdf/2607.27595v1#page=4)
**表 1** 两位专家在五个标签上的一致性。计算范围是两人都接受的 1,930 条候选,所用标注为第三位专家裁定之前的标注。机会一致率指仅凭每位专家各自的标签频率就能预期的一致率,即 Cohen’s κ 所校正的部分。[PDF 第 5 页](https://arxiv.org/pdf/2607.27595v1#page=5)
| 维度 | 观察一致率 | 机会一致率 | Cohen’s κ |
| --- | --- | --- | --- |
| 复用形式(直接引用/转述) | 87.3% | 56.1% | 0.71 |
| 复用层面(内容/结构) | 98.9% | 96.1% | 0.70 |
| 来源标记(显性/有标记/无标记) | 85.9% | 39.8% | 0.77 |
| 互文功能(背景/支持/……) | 58.9% | 39.5% | 0.32 |
| 立场(肯定/中立/……) | 77.0% | 68.4% | 0.27 |
在标签不集中于单一类别的维度上,模型的表现也呈现出这条梯度。与各模型自身的多数类基线相比,标签准确率在复用形式上提高 18~37 个百分点,在来源标记上提高 25~43 个,在互文功能上提高 12~25 个,在复用层面和立场上分别至多提高 2 个和 9 个。分歧出自任务本身,下面这个有争议的条目可以说明。《汉书》中有一段臣子为皇太子辩护的话,一条互文对把它与《论语》的「敏而好學」联系起来。两位专家都接受这条互文对,也都判定它是无标记的直接引用,立场为肯定。他们只在引用的用意上有分歧:一位认为是用经典支持臣子的主张,另一位认为是把经典衡量人才的标准用在皇太子身上;第三位专家裁定为应用。文本表面没有任何线索能决定这一点,而候选池中有 345 条与它情形相同:互文对被接受,复用形式和来源标记一致,互文功能在支持与应用之间分歧。出处:[专家评测 · PDF 第 4~5 页](https://arxiv.org/pdf/2607.27595v1#page=4)
## 4. 相似度检索会漏掉多少复用?
约四分之一经专家裁定的互文对,两侧片段没有一处相同的连续三字。对这些互文对,即使直接用专家标出的史书侧片段查询稠密检索器,也只有 61.0% 能在前十条结果中检出与《论语》侧片段重叠的句子。
在 2,533 条经专家裁定的互文对中,25.8% 的两侧片段没有一处相同的连续三字,40.8% 没有相同的连续四字。汉武帝的一道诏书以孔子对不同国君的回答各不相同为由,为调整施政重点辩护:「孔子對定公以徠逺」。诏书点出了孔子,却与所援引的教诲「近者說,遠者來」(《论语》第 13 篇《子路》)没有一个字相同。班固《叙传》中的赋,把《论语》第 18 篇《微子》中子路问津的故事压缩为「溺招路以從己兮」,隐者与弟子各只剩名字里的一个字,也没有标明出处。出处:[专家评测 · PDF 第 4 页](https://arxiv.org/pdf/2607.27595v1#page=4)
我们给了稠密检索一个实际系统不会有的便利:直接用专家标出的史书侧片段查询 `BGE-M3`。没有相同连续三字的互文对,只有 61.0% 能在前十条结果中检出重叠的源句(排在第一位的为 33.0%),逐字锚定的互文对则为 91.7%。在 1,470 个《论语》句子单元中,那道诏书和那篇赋的来源分别排在第 232 位和第 470 位。无连续三字重合的这一层,中位排名为 4,逐字锚定的互文对为 1。这些命中率决定了任何先检索、后判读的流程所能达到的召回率上限,而受限最严重的,正是需要解读的那部分复用。检索的输出也既没有字符区间,也没有标签。出处:[专家评测 · PDF 第 4 页](https://arxiv.org/pdf/2607.27595v1#page=4)
在整个文本块对的层面,限制同样存在:要保留专家确认的每一处复用,稠密嵌入与稀疏嵌入预过滤分别只能剔除 2.5% 和 1.1% 的文本块对,两者合用只能剔除 0.3%,因为字面相似度和分布相似度都会系统地漏掉转述。出处:[引言 · PDF 第 1 页](https://arxiv.org/pdf/2607.27595v1#page=1)
## 5. 十二个大语言模型在精确率、成本和校准上有何差别?
对照基准,各模型的精确率在 55.9%~92.9% 之间,十二个模型中有八个不低于 82%。质量与成本并不同步:精确率最高的 `doubao-2.1-turbo`,每条有效互文对的成本是 `deepseek-v4-flash` 的 51 倍;后者精确率低 4.9 个百分点,但精确率与成本之比最高,因此我们选它做全量运行。
**表 2** 十二个模型在 2,400 个评测任务上的结果:候选数、有效互文对数、精确率(已提交的互文对中经专家裁定为有效的比例)、总成本、每条有效互文对的成本,以及每个任务的中位时延。[PDF 第 6 页](https://arxiv.org/pdf/2607.27595v1#page=6)
| 模型 | 候选 | 有效 | 精确率 | 成本(美元) | 每条有效互文对的成本(美元) | 中位时延(秒) |
| --- | --- | --- | --- | --- | --- | --- |
| `doubao-2.1-turbo` | 367 | 341 | 92.9% | 853 | 2.501 | 521 |
| `deepseek-v4-pro` | 426 | 394 | 92.5% | 42 | 0.107 | 101 |
| `glm-5-turbo` | 460 | 410 | 89.1% | 215 | 0.525 | 126 |
| `deepseek-v4-flash` | 443 | 390 | 88.0% | 19 | 0.049 | 131 |
| `doubao-2.1-pro` | 495 | 426 | 86.1% | 241 | 0.566 | 183 |
| `qwen3.7-plus` | 492 | 416 | 84.6% | 68 | 0.163 | 178 |
| `gemini-3.1-flash-lite` | 384 | 324 | 84.4% | 115 | 0.355 | 37 |
| `glm-5.2` | 583 | 478 | 82.0% | 98 | 0.205 | 162 |
| `qwen3.7-max` | 520 | 414 | 79.6% | 122 | 0.294 | 194 |
| `gpt-5.4-mini` | 455 | 350 | 76.9% | 227 | 0.648 | 39 |
| `gpt-5.5` | 815 | 572 | 70.2% | 1,029 | 1.799 | 38 |
| `claude-haiku-4.5` | 578 | 323 | 55.9% | 647 | 2.003 | 163 |
| 合计 | 6,018 | 4,838 | | 3,676 | | |
时延与这两者也不同步:`doubao-2.1-turbo` 同时是最慢的模型(每个任务的中位时延为 521 秒),而最快的几个模型(37~39 秒)精确率高低悬殊(表 2)。出处:[专家评测 · PDF 第 5 页](https://arxiv.org/pdf/2607.27595v1#page=5)
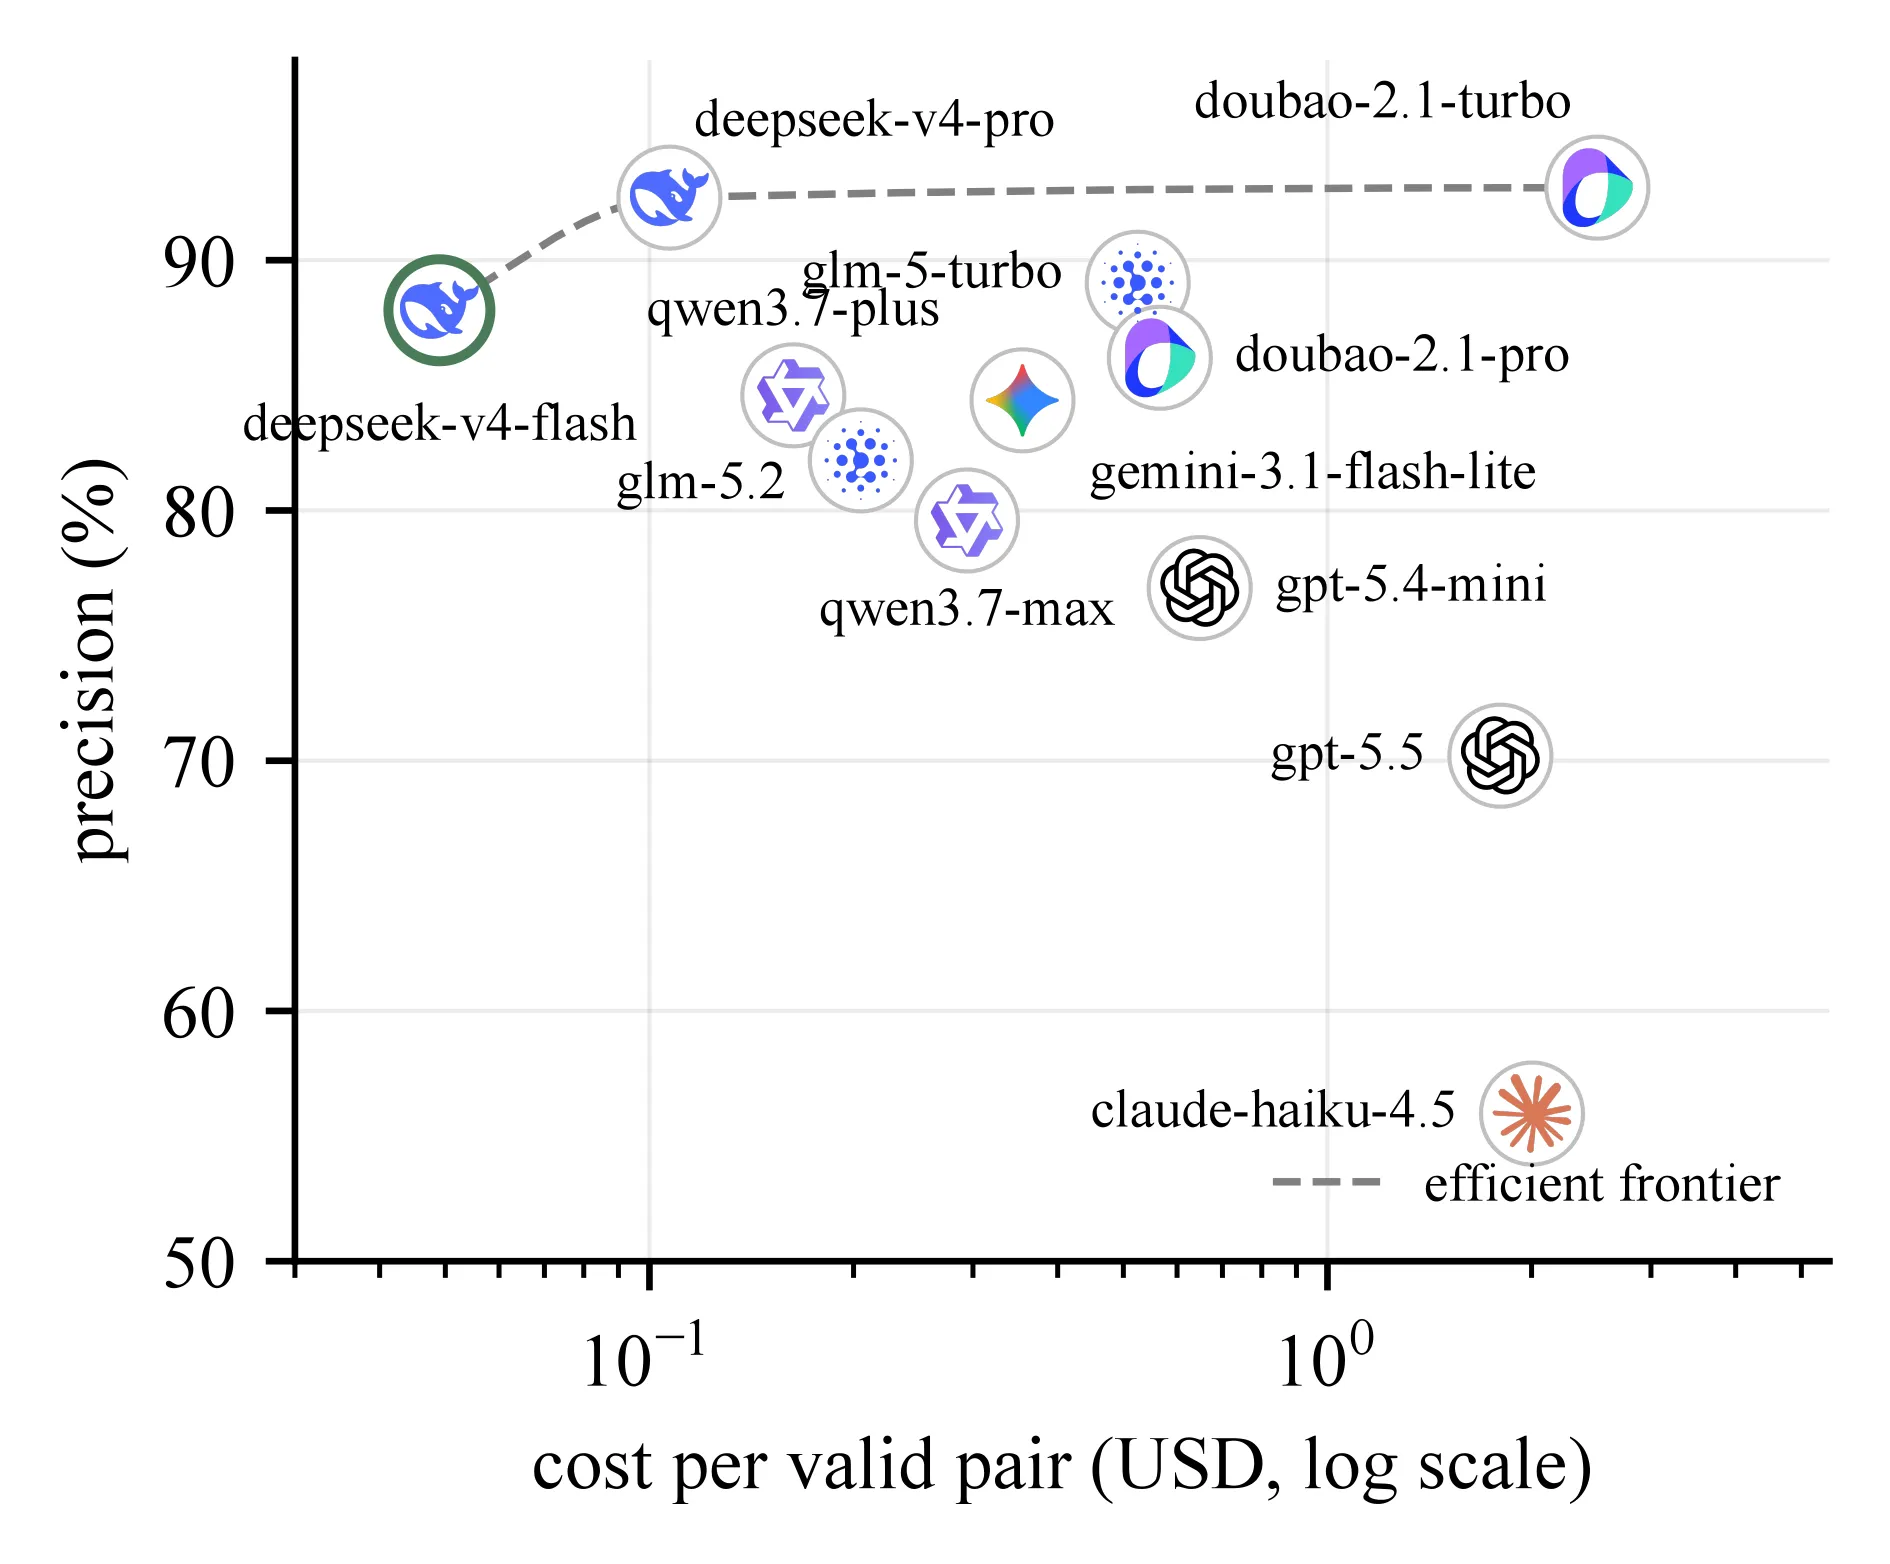
**图 2** 十二个大语言模型的精确率与每条有效互文对的成本(对数刻度),基准为 2,533 条互文对。选定的部署模型 `deepseek-v4-flash` 精确率与成本之比最高;各项计数见表 2。[PDF 第 5 页](https://arxiv.org/pdf/2607.27595v1#page=5)
模型自报的置信度有参考价值,但偏于乐观。汇总十二个模型,置信度区分有效与无效候选的曲线下面积(AUC, Area Under the Curve)为 0.85;自报置信度不低于 0.9 的候选,96.6% 有效(仅看 `deepseek-v4-flash`:AUC 0.84,96.1%)。置信度低于 0.9 时,模型自报的置信度系统地高于候选的实际有效比例(图 3)。出处:[专家评测 · PDF 第 5 页](https://arxiv.org/pdf/2607.27595v1#page=5)
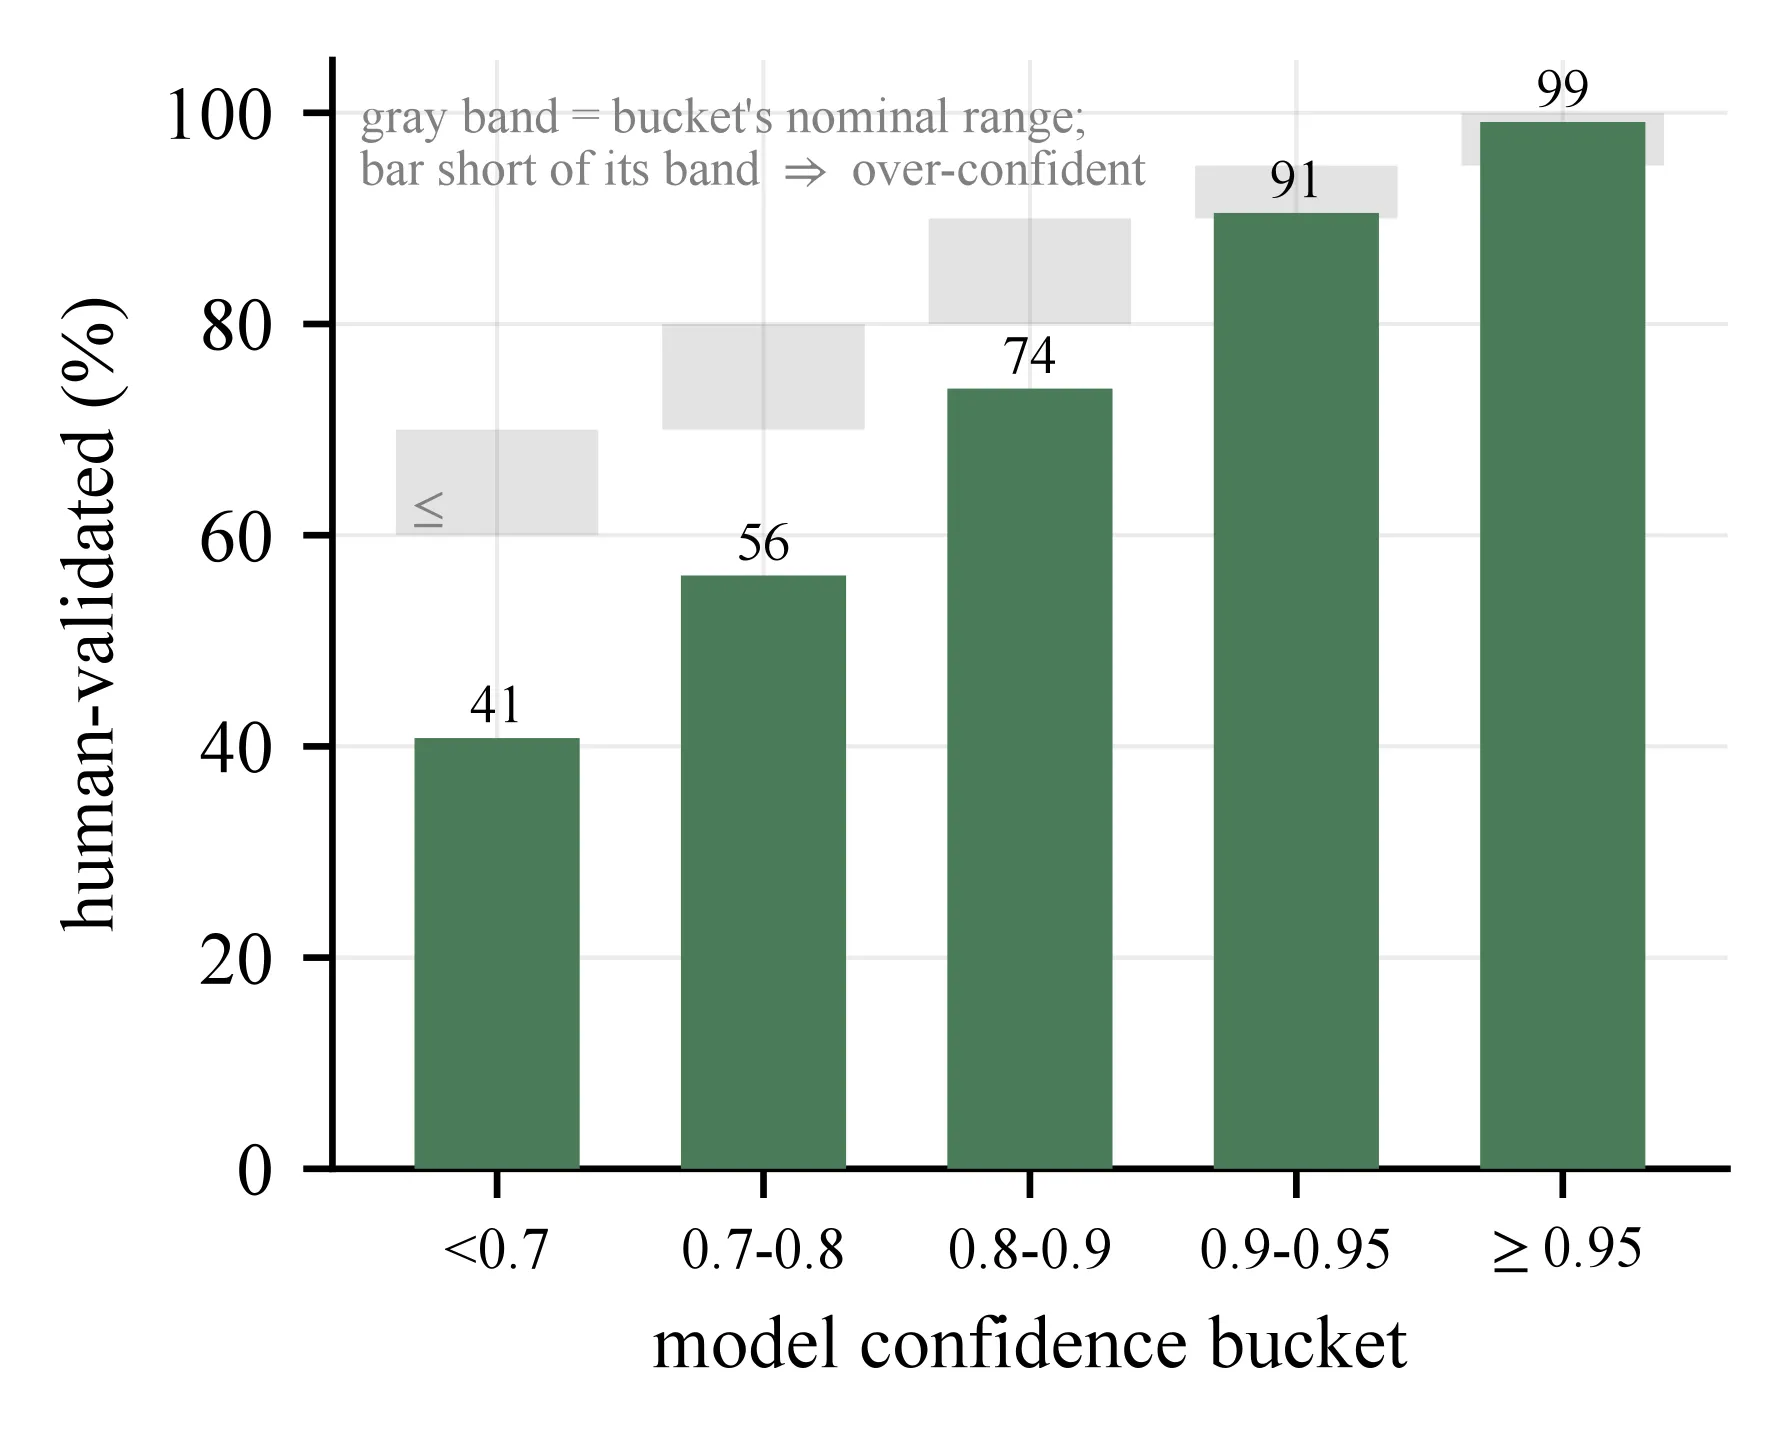
**图 3** 模型自报置信度的校准,汇总十二个模型:各置信度桶内判为有效的候选比例。柱子未达到灰色色带,说明模型在该桶内过于自信。[PDF 第 6 页](https://arxiv.org/pdf/2607.27595v1#page=6)
由两个及以上模型共同提出的候选,88.5% 有效;只由一个模型提出的为 65.1%。可见模型之间的一致是候选有效的信号。不同模型找到的是互文空间的不同部分,汇集而成的基准把这些部分合在一起。出处:[专家评测 · PDF 第 5 页](https://arxiv.org/pdf/2607.27595v1#page=5)
## 6. 二十四史在十八个世纪里如何复用《论语》?
在成书于公元前 91 年至 1739 年的各部史书之间,复用类型的构成未检出系统性变化;但较晚成书的史书引用同一段原文时,往往不如较早的史书贴近字面。
我们用 `deepseek-v4-flash` 把《论语》与二十四史的每一卷配对,共 65,380 个文本块对任务,涉及约 2,850 万字符,没有失败的任务,共得到 5,766 条互文对。精确率只在《汉书》上测过;按这一精确率估计,大约每八条中有一条是误报。因此,我们把输出看作一组模型判断的分布;作出这些判断的模型,其精确率和校准已在基准上测定。结论建立在分布的结构上,不依赖原始总数;每条互文对都附有置信度,想收紧阈值的读者可以据此筛选。出处:[扩展到二十四史 · PDF 第 5 页](https://arxiv.org/pdf/2607.27595v1#page=5)
### 一段原文,三种复用
禅让册命所在的合并片段簇共有 85 条互文对,分布在 22 部史书中。《汉书》点明出处,几乎逐字引用:「咨爾舜,天之歷數在爾躬」,标注为直接引用、显性、支持,字面忠实度 0.87;点出经典,是为了借重它的权威。同书一道拜将的册文吸收了册命的措辞,标注为直接引用、无标记、应用(0.37),册命的语言在这里转为日常施政的公文:「往悉爾心,統辟元戎,折衝綏遠,匡正庶事,允執其中。」《三国志》的禅让诏书以「天禄永终,历数在晋」移交天命,标注为转述、无标记、应用(0.25)。标签把公开借重经典的权威、不动声色的行政挪用和公式化的文书区分开来;而仅在这一个簇里,字面忠实度已呈现随成书年份下降的趋势。出处:[扩展到二十四史 · PDF 第 5~6 页](https://arxiv.org/pdf/2607.27595v1#page=5)
### 复用类型的构成未检出历时变化
659 年及以前成书的史书与 945 年及以后成书的史书相比,无标记复用的占比分别为 77.5% 和 77.6%。五个维度中,没有一个维度的主导类别占比与成书年份的相关在置换检验中达到 p < 0.05(表 3;互文功能和立场仍属探索性结果)。各部史书的复用类型分布也未见随成书年代相隔拉大而分化:两部史书之间的 Jensen–Shannon 散度与相隔年数未检出相关(置换检验 p = .12~.28)。从较早的史书到较晚的史书,原始引用密度确实降到约三分之一;但这一计数层面的趋势用不着类型学,也与通行的分期相符,所以我们不据此立论。出处:[扩展到二十四史 · PDF 第 6 页](https://arxiv.org/pdf/2607.27595v1#page=6)
**表 3** 二十四史中复用类型的构成。早期、晚期分别合并 659 年及以前成书、945 年及以后成书的史书计算占比。ρ 是主导类别在各部史书中的占比与成书年份的 Spearman 相关系数(共 24 部史书),p 是 2,000 次置换得到的置换检验 p 值。各项趋势的 p 都不低于 0.05。[PDF 第 6 页](https://arxiv.org/pdf/2607.27595v1#page=6)
| 维度 | 主导类别 | 早期 | 晚期 | *ρ* | *p* |
| --- | --- | --- | --- | --- | --- |
| 复用形式 | 直接引用 | 40.9% | 42.4% | −0.07 | .73 |
| 复用层面 | 内容 | 98.1% | 98.2% | −0.28 | .18 |
| 来源标记 | 无标记 | 77.5% | 77.6% | 0.11 | .60 |
| 互文功能 | 支持 | 67.8% | 70.8% | −0.11 | .61 |
| 立场 | 肯定 | 73.8% | 79.8% | 0.16 | .44 |
下文会看到,单段原文在流传中屡经改写,这与复用类型的构成未检出变化并不矛盾。文化吸引理论解释文化如何传播:它预期群体层面的分布保持稳定,因为传播中的改写会趋向若干共同的形式,不必每次都忠实复制。出处:[扩展到二十四史 · PDF 第 6 页](https://arxiv.org/pdf/2607.27595v1#page=6)
不标出处地吸收经典,在早期和晚期史书中都占复用的四分之三以上,而中国传统学术本身就认可这种做法。章学诚区分著作之体与考据之体,认为「著作之體,援引古義,襲用成文,不標所出,非為掠美」。但他只把这种许可给予论说足以自立、无须倚重所引之言的作者。刘勰在 6 世纪就已认为,旧典用得贴切,便如同出自作者之口。出处:[扩展到二十四史 · PDF 第 6 页](https://arxiv.org/pdf/2607.27595v1#page=6)
### 字面忠实度代替不了来源标记
字面忠实度的计算方法是:按字符级最长公共子序列,把每个史书片段与它的《论语》源文对齐。一段话引得多贴近字面,并不决定它如何标记来源。点名来源的引用比无标记的引用字面忠实度更高(中位数 0.78 对 0.38,Kruskal–Wallis 检验 p < 10⁻³);只看直接引用,差距依然存在(0.85 对 0.50)。所以相似度分数不能代替来源标记这个标签。点名来源就是公开借重经典的权威,措辞也因此要守更严的标准。这只是一种规律,并非定律:如果作者有意隐去来源,无标记的引用同样可以一字不差。出处:[扩展到二十四史 · PDF 第 6 页](https://arxiv.org/pdf/2607.27595v1#page=6)
### 应用型引用往往不那么贴近字面,多数不标来源(探索性结果)
标为支持的引用比标为应用的引用更贴近经典的字面(字面忠实度均值 0.50 对 0.42)。应用型引用把经典用于治理和政策,93% 不标来源。这正是传统学术所说的「通经致用」:引文的分量在于圣人会赞同这项决定,不在于圣人的原话。互文功能是专家一致性较低的维度(表 1)。出处:[扩展到二十四史 · PDF 第 6 页](https://arxiv.org/pdf/2607.27595v1#page=6)
### 较晚的史书引用同一段原文,往往不那么贴近字面
固定同一段原文来看,较晚成书的史书引用它时往往不那么贴近字面(图 4)。符合条件的合并片段簇共 283 个,每簇至少涉及五个不同的成书年份。簇内字面忠实度与成书年份的 Spearman 相关系数平均为 −0.15(69.3% 的簇为负;簇级自助法 95% 置信区间为 [−0.19, −0.12];置换检验 p < 0.001)。直接引用的下降比转述更陡(−0.18 对 −0.08);只看置信度不低于 0.9 的互文对,这一趋势更明显(172 个簇,ρ = −0.19,p < 0.001)。章学诚早已看到流传会改动措辞:「司馬遷點竄尚書左國之文,班固點竄司馬遷之文,非好異也,理勢之不得不然也」。出处:[扩展到二十四史 · PDF 第 7 页](https://arxiv.org/pdf/2607.27595v1#page=7)
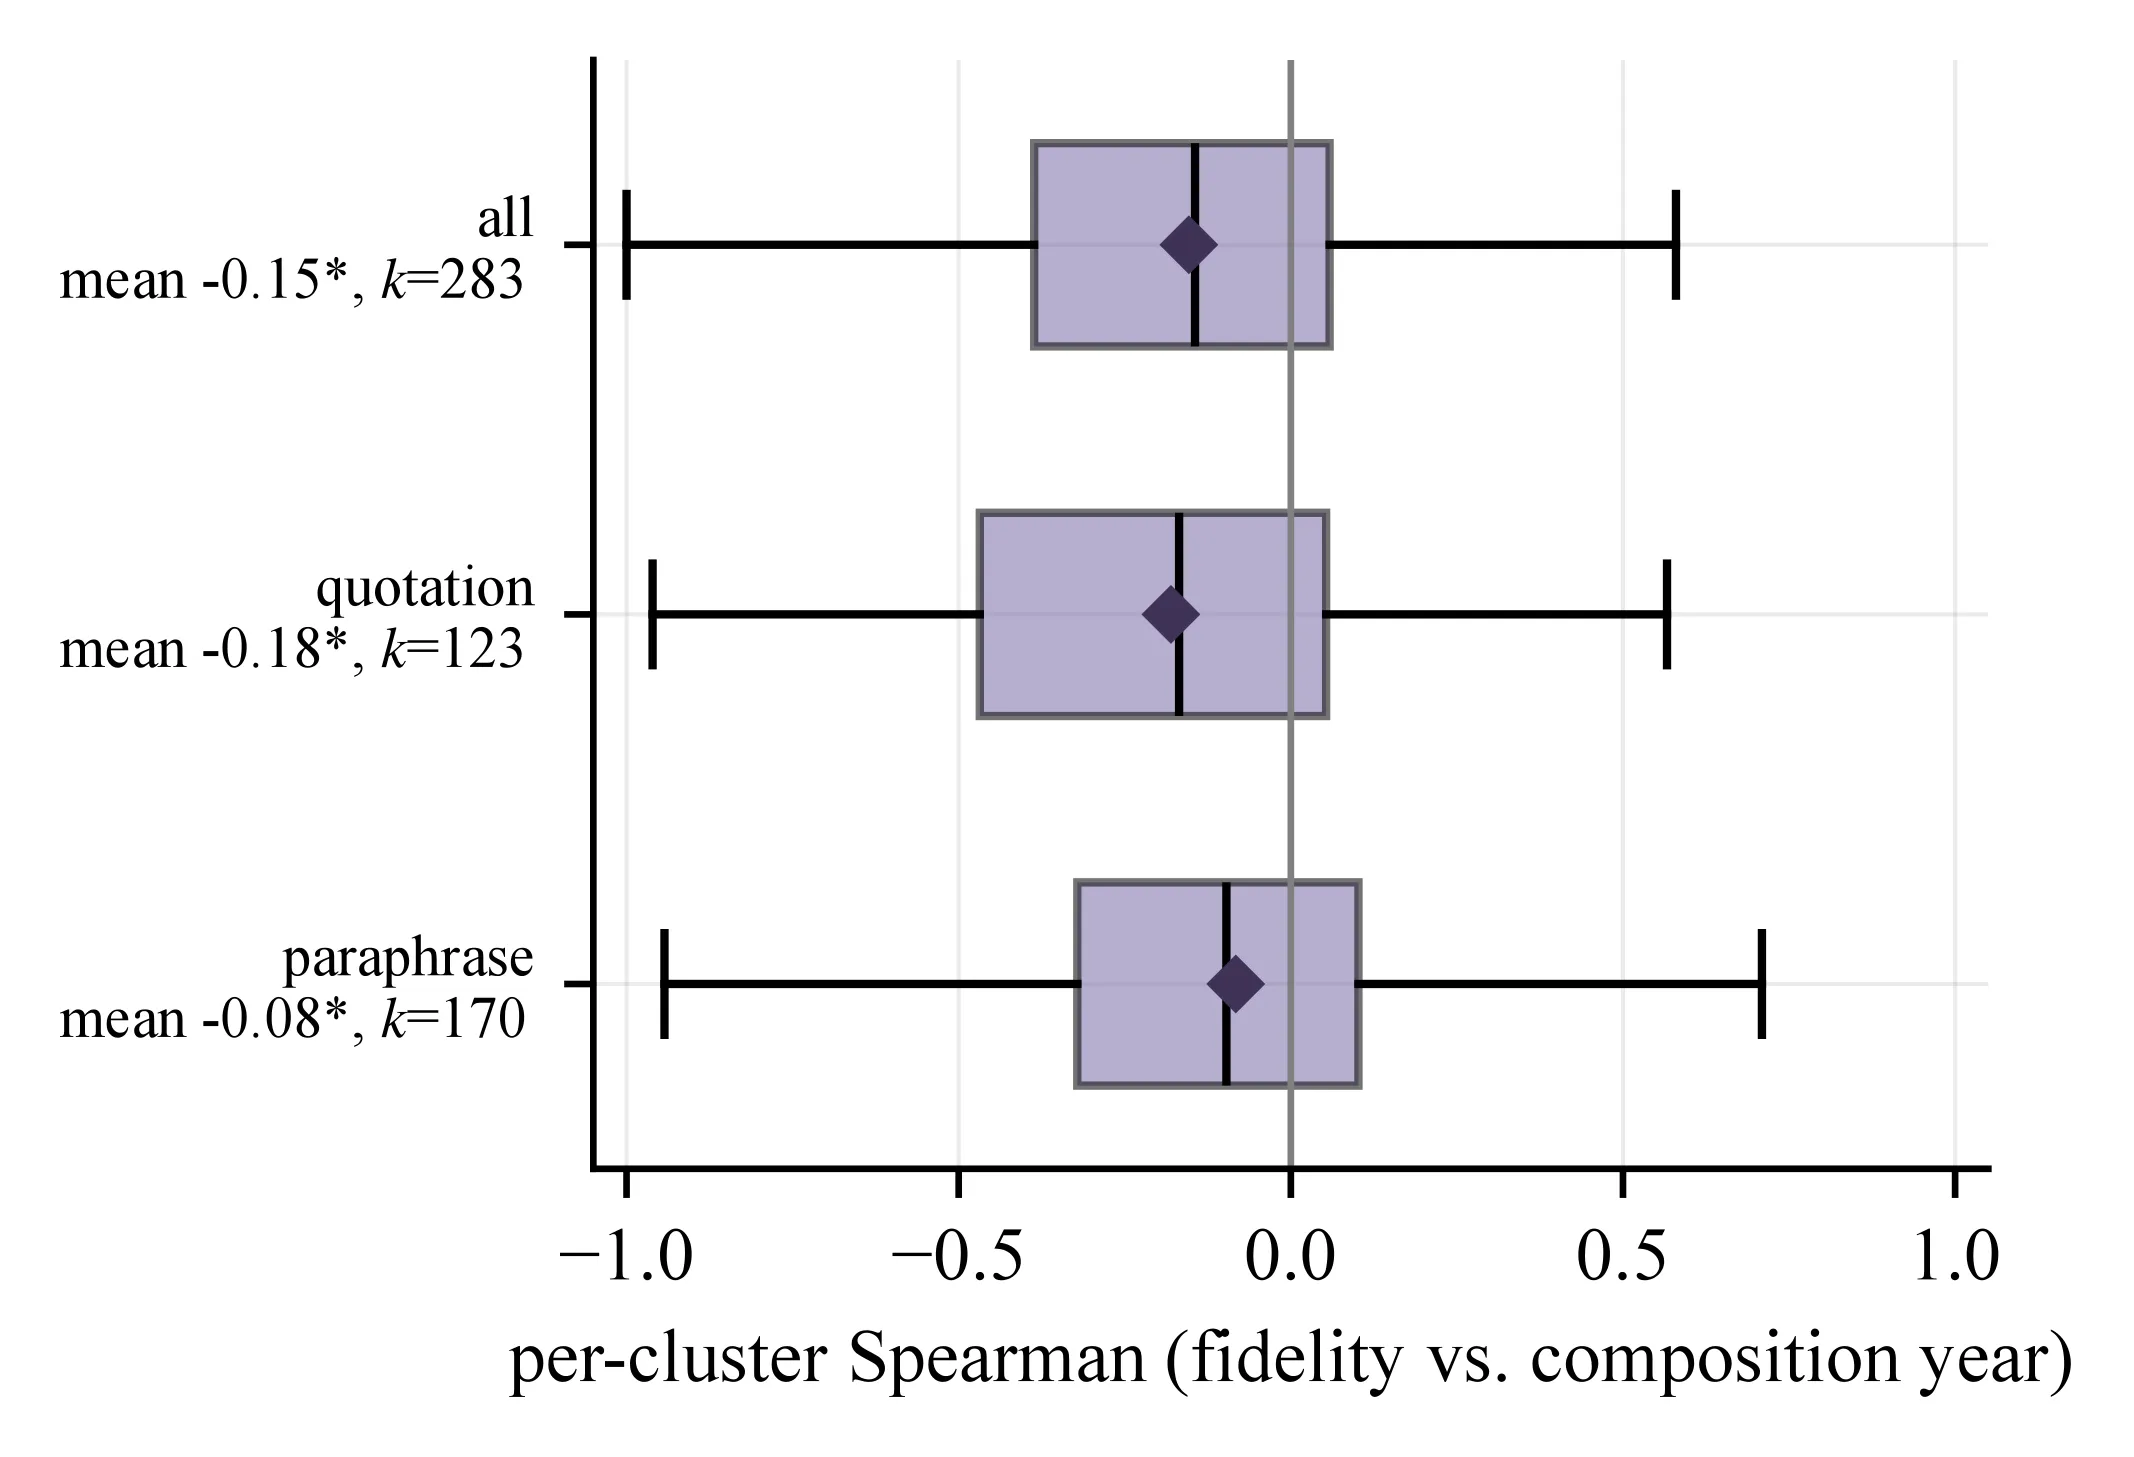
**图 4** 固定同一段原文,引用它的史书成书越晚,字面忠实度往往越低。图为各簇忠实度与成书年份的 Spearman 相关系数分布。箱体为四分位距,菱形为各层均值,星号表示置换检验 p 小于 0.05,*k* 为符合条件的簇数。[PDF 第 7 页](https://arxiv.org/pdf/2607.27595v1#page=7)
### 固定切分无法对齐的复用
完整读入每个文本块,还能找到两侧长短不一的复用。《汉书》称赞汉成帝仪容的一句「升車正立,不內顧,不疾言,不親指」,取材于《论语·乡党》中两处分开的记述:「升車,必正立,執綏」和「車中,不內顧,不疾言,不親指」。两条互文对都经裁定有效。如果按句子对句子排序,只能选中其中一句《论语》,或者把分数分摊到两句上。全量运行中共有 117 组这样的复用:同一个史书侧字符区间,对应《论语》中两处及以上互不重叠的段落。出处:[扩展到二十四史 · PDF 第 7 页](https://arxiv.org/pdf/2607.27595v1#page=7)
## 局限
全量运行只用了一个模型,它的精确率只在《汉书》上测过。我们依据的几项发现,在置信度不低于 0.9 的互文对中依然成立,而且更明显;这部分互文对占全量运行的 55.3%,所以这些发现并不依赖低置信度的互文对。在基准上,`deepseek-v4-flash` 置信度达到这一水平的候选有 96.1% 有效。所有复用计数都只是下限,因为只有某个模型提出过的互文对才能计入。出处:[讨论与局限 · PDF 第 7 页](https://arxiv.org/pdf/2607.27595v1#page=7)
模型可能在训练中吸收过前人对这些复用的考证,所以我们把这个系统定位为辅助工具。这种数据污染的影响并不均匀:模型可能记住的个案集中在著名的、标明出处的引用上,而在语料规模上真正有价值的是无标记的转述,索引并不收录这类复用。每部史书在历时分析中都只取一个成书年份,尽管有几部前后编了几十年;早期与晚期的划分也沿用通行的分期。出处:[讨论与局限 · PDF 第 7 页](https://arxiv.org/pdf/2607.27595v1#page=7)
这个基准只覆盖《论语》与《汉书》这一组文献,是受控的评测场景,并非通用的互文基准。出处:[讨论与局限 · PDF 第 7 页](https://arxiv.org/pdf/2607.27595v1#page=7)
## 使用本研究
目前公开的资源有两项:[arXiv](https://arxiv.org/abs/2607.27595) 上的论文,以及[互文图谱](https://analects-24histories-intertext.pkudh.net/)。互文图谱在原文上下文中展示二十四史全量运行得到的每条互文对,连同字符区间和标签;它还把互文对归入簇,用来追踪一段原文的接受史。
这套协议只需要两部可以切分的文献和一套用于标注的复用类型学,几乎没有专属于《论语》或中文的部分。凡是需要把复用落实到精确字符区间的场合,都可以用它的校验。出处:[讨论与局限 · PDF 第 7 页](https://arxiv.org/pdf/2607.27595v1#page=7)
## 引用
```bibtex
@misc{wang2026beyond,
title = {Beyond Similarity: Grounded Agentic Extraction and Expert-Adjudicated Evaluation of Intertextuality in Classical Chinese Histories},
author = {Wang, Zhaoji and Si, Wanyu and Wang, Jun},
year = {2026},
eprint = {2607.27595},
archivePrefix = {arXiv},
primaryClass = {cs.CL},
doi = {10.48550/arXiv.2607.27595},
url = {https://arxiv.org/abs/2607.27595}
}
```
## 致谢
本文的研究得到国家重点研发计划项目「面向民族地区跨语境无障碍交互技术装备研究」(2025YFC3309300)和国家自然科学基金国际重点合作项目「中国儒家学术史知识图谱构建研究」(项目号:72010107003)的支持。
© 2026 王兆基、司宛玉和王军。页面文字与插图保留所有权利。代码采用 MIT 许可证。